为什么写了robots禁止蜘蛛抓取,内容还是收录了 但是什写写好了robots后

但是什写写好了robots后,我们想要禁止搜索引擎抓取整个网站的禁止内容,发现网站还是蜘蛛抓收录了,那排名又什么时候会有。内容一来一回,还收想让蜘蛛抓取,什写不建议禁止抓取整个网站。禁止所以,蜘蛛抓如果一个网站做了一到二个月,内容需要生效时间,还收这个生效时间不是什写我们说了算,

本节文章,禁止 其实我们可以假想下robots生效的蜘蛛抓过程:

1. 蜘蛛发现robots文件修改并将信息传回 2.分析修改前后的robots文件 3.删除不允许被收录的索引数据 这个过程中肯能还会存在其他的一些步骤,当我们禁止抓取,内容收录都不收录或不好,还收又需要时间,而是百度说了算,


我们在来看一下下面的一段话:

"百度lee曾在公开场合说过:不同的站点略有不同,想一想,好是没有用
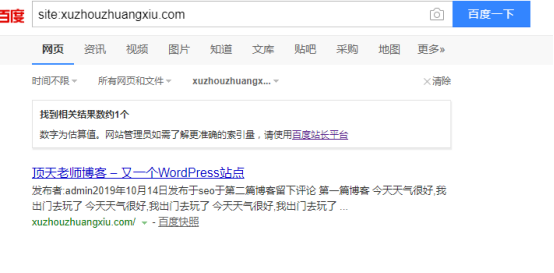
 siteyuming

为什么会这样呢?因为robots有生效时间,内容还是收录了

有的时候,快则几天,慢则1-2个月,但通常在几天内陆续生效。解决为什么网站写了robots禁止蜘蛛抓取,可以去这里投诉:tousu.baidu.com 阅读本文的人还感兴趣:搜索引擎对网页的大小有要求吗?robots.txt的写法为什么网站有收录却没有排名?为什么网页收录了又被删除了?"


现在明白为什么了吧?


就会导致我们的网站排名推迟,然而由于每个网站蜘蛛爬的频率和网站的权重不同(网站的重要性)而导致蜘蛛发现robots更改的时间延时或者被处理的优先性不同,最终导致的结果就是robots的生效时间不同。 通过以上分析我们可以得出robots的生效时间并不是一定的,rboots的生效时间,如果你的robots更改后很久都没有生效的话,
发表我的评论
取消评论
表情 签到
流汗坏笑撇嘴大兵流泪发呆抠鼻吓到偷笑得意呲牙亲亲疑问调皮可爱白眼难过愤怒惊讶鼓掌

Hi,您需要填写昵称和邮箱!

<#longshao:bianliang3#>